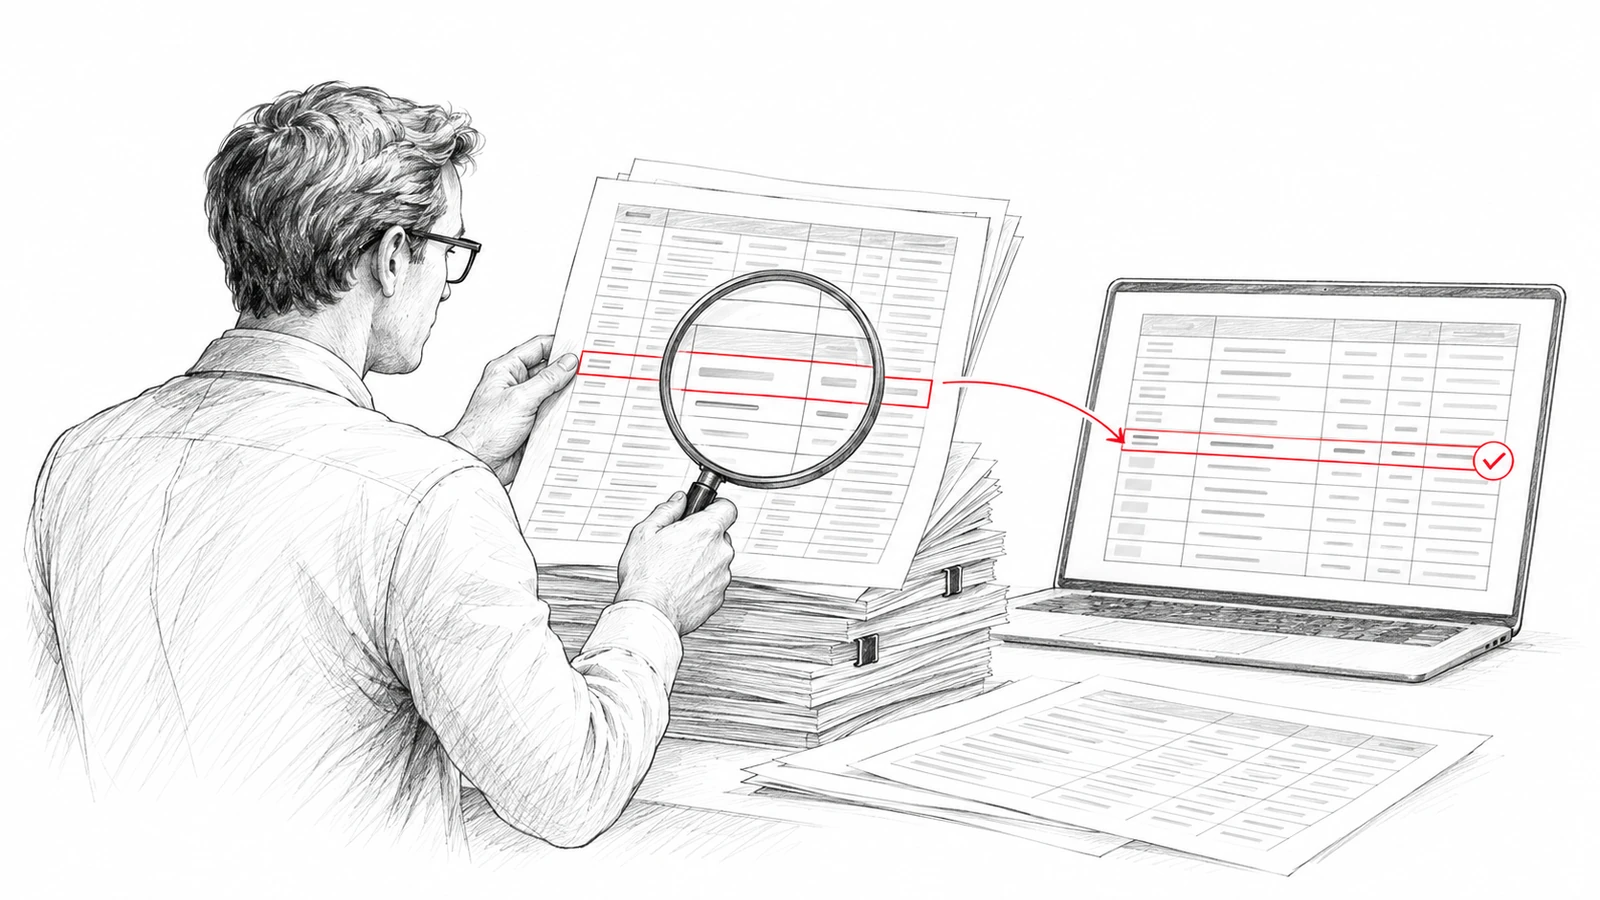
Витягнуті дані ще потрібно перевірити
- LLM може витягнути дані з документа. Для використання в обліку потрібно перевірити їхню повноту, правильність і відповідність джерелу.
- Правильний підсумок і коректний JSON не доводять правильності кожної операції.
- Ефект автоматизації оцінюють після перевірки та запису даних в облік, з урахуванням часу людини й виправлень.
Останнім часом усе частіше чую від компаній: «Навіщо нам окреме рішення для розпізнавання? Це вже можна зробити за допомогою LLM».
Можна. Сучасні моделі, які працюють із текстом і зображеннями, справді вміють читати документи, витягувати реквізити й повертати таблиці.
Беремо хороший рахунок на одну сторінку. Завантажуємо. Просимо витягнути номер, дату, постачальника, суму. Отримуємо акуратну відповідь.
Виглядає переконливо. Особливо якщо це перший документ, який ви так обробили.
А тепер спробуймо пройти трохи далі — до того моменту, коли бухгалтер має використати ці дані в обліку й відповідати за їхню правильність.
Для початку — акт звірки на 43 сторінки
Дрібний шрифт. Щільна таблиця. Дати, номери документів, дебет, кредит. Заголовки повторюються на кожній сторінці.
Завдання просте: витягнути всі операції та звірити їх із даними облікової системи.
Саме всі. Бо для звірки потрібна кожна операція.
І тут я пропоную поставити консультанту кілька приземлених запитань.
Як ви перевірите, що модель не пропустила рядок на 27-й сторінці?
Що сума належить саме цьому документу, а не сусідньому?
Що рядок, який почався внизу однієї сторінки й продовжився на наступній, зібраний правильно?
Що повторений заголовок не став операцією, а проміжний підсумок не потрапив у список платежів?
І що дві схожі операції справді дві, а не «дубль», який система вирішила прибрати?
Це конкретні сценарії, які потрібно перевіряти на реальних документах.
OpenAI прямо описує серед обмежень візуальних моделей дрібний текст, повороти зображення, неточність просторового визначення та можливі помилки. У документації Anthropic окремо зазначено: щільні PDF із дрібним шрифтом і складними таблицями можуть вичерпати контекст раніше, ніж буде досягнуто ліміту сторінок. [1] [2]
Сам факт, що сервіс прийняв файл на 43 сторінки, ще нічого не говорить про повноту витягнутої таблиці. Обсяг вхідного документа й обсяг відповіді — різні обмеження.
«Тоді поріжемо документ на сторінки».
Так, це може допомогти. Далі потрібно зібрати таблицю назад: зберегти порядок, правильно обробити переходи, прибрати повторені заголовки, проконтролювати завершення кожного фрагмента.
Завдання вже помітно більше за «завантажити PDF і написати правильний промпт».
Суми зійшлися. Можна видихати?
Припустімо, в акті є дві накладні: на 12 480 грн і на 18 720 грн.
Система витягнула обидві суми, але поміняла їх місцями між номерами документів.
Загальний оборот збігається до копійки. Кількість рядків теж. А звірка з обліком покаже розбіжності по обох накладних.
Або інший варіант: суми правильні, але дата однієї операції змінилася. Тепер вона потрапляє в інший період.
Перевірка арифметики цього не помітить.
Ще один сценарій: пропущено нарахування й оплату на однакову суму. Кінцеве сальдо може залишитися правильним, хоча дві операції зникли.
Тому для акту звірки потрібно окремо контролювати обороти, початкове й кінцеве сальдо, повноту операцій, дати, номери та відповідність сум конкретним рядкам. Навіть разом ці перевірки не дають автоматичної гарантії: неоднозначні місця все одно потребують розбору.
Правильний підсумок — корисна перевірка. Але він не доводить, що кожна позиція правильна.
Те саме стосується накладних. Документ на 200 позицій може мати правильну загальну суму й помилковий артикул в одному рядку. Для складу така помилка цілком відчутна.
До речі, акуратний JSON теж нічого не доводить. Це формат даних. У нього чудово поміщаються неправильні дати й суми. Навіть OpenAI зазначає, що відповіді у режимі Structured Outputs можуть містити помилки. [3]
«Нехай AI сам себе перевірить»
Мені подобається ця пропозиція. Особливо хочеться зрозуміти, що саме він перевірятиме.
Якщо модель отримала вже витягнуту таблицю й перерахувала підсумки, вона перевірила арифметику цієї таблиці.
Пропущений рядок у ній не з’явиться лише тому, що суми додали ще раз.
Якщо модель повторно читає оригінал, це може виявити частину помилок. Якщо інша модель робить незалежне витягування — теж може допомогти.
Але збіг двох відповідей сам по собі не доводить правильності. Обидві моделі можуть однаково прочитати нечітку цифру або не помітити той самий фрагмент.
Потрібно зрозуміти, які помилки кожна перевірка здатна виявити й чого вона не бачить.
Із «впевненістю 99%» схожа історія. Якщо модель просто написала цю цифру у відповіді, ми ще не знаємо, як вона пов’язана з реальною частотою помилок на ваших документах.
Така оцінка стає корисною після перевірки на вибірці з відомими правильними відповідями. До цього це ще одне число, якому пропонують повірити.
Що саме означають ваші «99% точності»?
Ось тут розмова зазвичай стає цікавішою.
99% чого? Символів? Полів? Рядків? Документів, у яких правильно витягнуто все необхідне?
Візьмімо умовну таблицю на 2 000 рядків із вісьмома полями в кожному. Це 16 000 значень.
Навіть частка помилок 0,1% на такому обсязі відповідає 16 неправильним значенням.
Це ілюстрація масштабу, а не оцінка конкретної моделі чи акту. Але вона показує, чому красива точність на рівні окремого поля не означає безпомилкового документа.
Для бухгалтерії ще важливо, де саме помилка. Зайвий пробіл у назві й неправильна сума платежу мають різні наслідки.
Я б просив показувати результати окремо для критичних полів: сум, дат, номерів документів, кодів, артикулів. А також — частку документів, які пройшли весь процес без втручання людини й без виявлених критичних помилок.
І обов’язково дивився б на тихі помилки: коли система видала неправильні дані та дозволила використати їх далі.
Файл, який чесно пішов на перевірку, принаймні привернув увагу. Неправильна сума зі статусом «готово» може спокійно поїхати в облік.
«Ну, бухгалтер усе перевірить»
Бухгалтер уже має акт на 43 сторінки. Тепер йому дають ще й таблицю, якій не можна повністю довіряти.
Відкрий PDF. Знайди рядок. Порівняй дату. Перевір номер. Перевір суму. Повтори.
Якщо так треба пройти весь документ, варто порахувати фактичну економію часу. Витягування могло зайняти хвилину, а перевірка — годину.
Зручна валідація виглядає інакше: натискаєш на поле й бачиш відповідний фрагмент оригіналу. Система показує розбіжності та причину, через яку потрібна увага людини.
Для цього потрібен зв’язок між даними й джерелом: сторінка, рядок або координати ділянки документа. Посилання «дивіться сторінку 27» для щільної таблиці — доволі скромна допомога.
А якщо оригінал нечіткий і число неможливо надійно прочитати, нормальний результат — запит кращої копії чи ручне уточнення. Уточнення має відбутися до використання даних.
Людині можна передавати лише винятки, коли перевірено, що система достатньо надійно їх виявляє. Якщо такого підтвердження немає, обсяг ручного контролю доведеться збільшувати.
Тому фраза «у нас є людина в процесі» мало що пояснює. Покажіть, що саме вона перевіряє, як це робить і скільки часу витрачає.
Документ прочитали. Тепер його треба використати
Уявімо, що всі дані витягнуто правильно.
У накладній постачальник написав свою назву товару. У вашій BAS чи SAP той самий товар має іншу назву й інший код.
Постачальник указав 10 упаковок. У вас облік ведеться у штуках. Коефіцієнт перерахунку потрібно взяти з погоджених даних.
В акті є «оплата за договором». В обліковій системі — кілька договорів із цим контрагентом.
Усе прочитано правильно. Але для наступної дії цього поки недостатньо.
Потрібні правила зіставлення, довідники, перевірки та визначений порядок роботи з неоднозначними випадками.
Потім — перенесення даних в облікову систему. Тут теж є кілька нудних запитань.
Що станеться, якщо зв’язок обірветься після запису половини операцій?
Як система продовжить роботу й перевірить, що вже записано?
Як уникне повторного створення операцій після повторного запуску?
Для презентації ці деталі звучать так собі. Для бухгалтерії — цілком предметно.
Те саме з вартістю. До виклику моделі додаються підготовка файлів, повторна обробка, перевірки, ручні виправлення, інтеграція та підтримка.
Тому я б рахував вартість документа, який дійшов до потрібного результату в обліку, і час людини на цьому шляху.
Де LLM справді корисна — і що потрібно поруч із нею
Сучасні моделі можуть добре допомагати з класифікацією документів, пошуком реквізитів у різних форматах, розумінням формулювань і розбором нестандартних випадків. На частині задач модель може бути основним способом витягування даних.
Для разової роботи з кількома документами, коли людина переглядає результат, цього може бути достатньо.
Є й ще простіший випадок: дані вже доступні в Excel, XML, через API або в придатному для прямого витягування текстовому PDF. Тоді варто спочатку перевірити можливість забрати їх без повторного візуального розпізнавання.
А для регулярної обробки документів потрібен керований процес:
- Приймання й підготовка. Перевірити файл, сторінки, якість і спосіб отримання даних.
- Витягування. Зберегти структуру таблиць і зв’язок значень з оригіналом.
- Контроль. Перевірити повноту, критичні поля, арифметику та відповідність даним обліку.
- Валідація. Передати людині визначені винятки й дати зручний спосіб їх розібрати.
- Запис і підтвердження. Передати дані в систему, перевірити результат і коректно відновити роботу після збою.
Конкретний набір інструментів залежить від документів і вимог. OCR, спеціалізовані моделі й LLM можуть помилятися. Назва технології не звільняє від перевірки.
Компетентний консультант може побудувати все це з LLM у центрі. Тоді предметом розмови буде повноцінна система: її точність, контроль, вартість і поведінка при помилках.
Що попросити показати до впровадження
Я б узяв добірку звичайних робочих документів: від різних контрагентів, із довгими таблицями, різною якістю, виправленнями та незручними переходами між сторінками.
Окрему частину цієї добірки варто залишити для перевірки після налаштування рішення. Інакше легко виміряти, як добре його підготували до вже відомих прикладів.
Далі попросив би показати:
- Повну таблицю з довгого документа та спосіб перевірки пропущених і зайвих рядків.
- Зв’язок кожного критичного поля з місцем в оригіналі.
- Помилку, яку система виявила, і помилку, яку пропустила.
- Роботу оператора: що він бачить і скільки часу витрачає.
- Повторний запуск після збою та захист від повторного запису даних.
- Підсумкові витрати й частку документів, що потребують ручного втручання.
Окремо потрібно з’ясувати, де обробляються документи, які дані зберігаються й хто має до них доступ. Це має бути конкретна відповідь про обраний сервіс і налаштування.
Якщо вам показують лише вдало прочитаний рахунок, ви бачили вдало прочитаний рахунок. Досвід із 43-сторінковим актом звірки поки залишається відкритим питанням.
У INNORA ми працюємо з розпізнаванням документів через RaccoonDoc і автоматизацією процесів на UiPath. Тому починаємо з того, які дані потрібні клієнту, що необхідно перевірити й куди має потрапити результат.
Модель можна вибрати й змінити. Пропущений рядок однаково доведеться знайти. Неправильну суму — виправити. Повторно створену операцію — розібрати.
Тож коли наступного разу вам скажуть «LLM уже вирішила розпізнавання», дайте їй той самий акт на 43 сторінки.
І попросіть показати, як перевірено кожну операцію.
З цього місця починається розмова, за яку бізнесу справді варто платити.
Часті питання
Чи можна розпізнавати документи лише за допомогою LLM?
На частині задач — так. Для регулярної обробки фінансових документів потрібно також перевіряти повноту й критичні поля, обробляти винятки та контролювати передачу даних в облікову систему. Склад рішення визначають за результатами перевірки на документах клієнта.
Як перевірити акт звірки з таблицею на 43 сторінки?
Потрібно контролювати обробку всіх сторінок, пропущені й зайві рядки, переходи таблиці, дати, номери, дебет і кредит. Окремо звіряють обороти та сальдо, зіставляють операції з обліком і передають неоднозначні фрагменти на перевірку людині.
Чи доводить правильний підсумок правильність усіх рядків?
Ні. Суми можуть бути переставлені між документами, дати — неправильними, а нарахування й оплата на однакову суму — пропущеними. Загальний підсумок або кінцеве сальдо при цьому можуть збігатися.
Чи гарантує відповідь у JSON правильність даних?
Ні. JSON і відповідність схемі задають структуру відповіді. Вони не доводять, що всі значення відповідають оригіналу або що модель витягнула всі операції.
Навіщо прив’язувати поле до сторінки або координат документа?
Щоб людина могла швидко знайти джерело дати, номера чи суми та перевірити його. Такий зв’язок скорочує пошук по документу, але також потребує перевірки правильності.
Чи можна передавати бухгалтеру лише винятки?
Так, коли на документах клієнта підтверджено, що система достатньо надійно їх виявляє. Без такого підтвердження обсяг ручного контролю потрібно збільшувати.
Джерела та документація
- OpenAI: обмеження моделей для роботи із зображеннями
Дрібний текст, просторове визначення, зміна розміру та можливі помилки.
- Anthropic: вимоги та обмеження обробки PDF
Щільні документи, складні таблиці та обмеження контексту.
- OpenAI: Structured Outputs і помилки у відповідях
Відповідність схемі не виключає помилок у даних.
Приклади з сумами та розрахунок кількості помилок у статті — умовні ілюстрації. Це не результати тестування конкретної моделі чи 43-сторінкового акту.
Ігор Світельський
Засновник та CEO INNORA. Працює з автоматизацією бізнес-процесів, розпізнаванням документів RaccoonDoc та роботизацією на UiPath.